[ElasticSearch] 1. ElasticSearch 소개와 설치 및 실행
개요
이전에 개인 토이 프로젝트로 RAG를 이용한 블로그 검색 시스템을 만들어 본적이 있습니다. 그 당시에는 간단하고 빠르고 비용을 최소화하면서 만들기 위해서 무료로 벡터DB를 제공해 주는 SupaBase를 이용했었습니다. 하지만 매번 RAG 시스템을 만들면서 SupaBase를 이용하기에는 결국 SupaBase의 모든 기능을 사용하기 위해 SupaBase를 구독해야 하는 문제가 있었습니다. 또한 RAG 시스템의 성능은 대부분 LLM의 성능에 따르지만 LLM 성능과 함께 사용하는 벡터DB에도 많이 의존하고 있다는 것을 이전 토이 프로젝트를 통해 알게 되었습니다. 그래서 앞으로 진행할 회사의 솔루션 제품과 같이 RAG 시스템에 벡터DB가 포함되어 있는 프로그램을 만들기 위해서는 프로그램 내부에 포함시킬 수 있는 벡터DB가 필요해졌습니다. 그렇다고 벡터DB를 제가 처음부터 만들순 없어 제가 진행할 토이 프로젝트에 들어갈 수 있는 벡터DB를 찾아보니 현재 많은 기업들에서 사용하고 있고, 또 오픈소프트웨어인 ElasticSearch가 벡터DB 기능도 제공한다는 것을 알게 되었습니다. 또한 ElasticSearch의 경우 전 세계적으로도 유명한 정보 검색기이기 때문에 이번 기회에 공부도 하고 프로젝트 하기에 앞서 ElasticSearch를 한 번 정리도 할겸 해서 이번 포스트를 작성하게 되었습니다.
1. Elastic Stack 소개
2004년 샤이 베논(Shy Banon)은 Compass 라는 이름의 오픈 소스 검색엔진을 개발하였습니다. 샤이 배논이 처음 Compass 검색엔진 개발을 하게 된 계기는 요리 공부를 시작한 아내를 위해 레시피 검색 프로그램을 만들기 위해서였습니다. 레시피 검색 프로그램에 아파치 루씬(Apache Lucene)을 적용하려던 중 루씬이 가진 한계를 보완하기 위해 새로 검색엔진을 만들기 위한 프로젝트를 시작한 것이 계기입니다. 2010년 샤이는 Compass를 ElasticSearch라고 이름을 바꾸고 프로젝트를 오픈소스로 공개하였는데, 곧 수많은 검색 개발자들에게 인기를 얻으며 급속도로 성장하기 시작했습니다.
ElasticSearch 프로젝트는 2012년에 창시자 샤이 배논과 함께 스티븐 셔르만(Steven Schuurman), 우리 보네스(Uri Boness) 그리고 아파치 루씬 커미터인 사이먼 윌너(Simon Willnauer) 4인의 멤버에 인해 네덜란드 암스테르담에서 처음 회사로 설립되었으며 현재는 주 본사인 네덜란드 암스테르담과 캘리포니아 마운틴 뷰를 비롯한 전 세계에 직원들이 분포되어 있습니다.
Logstash, Kibana와 함께 사용되면서 한동안 ELK Stack(ElasticSearch, Logstash, Kibana)이라고 널리 알려지게된 Elastic은 2013년에 Logstash, Kibana 프로젝트를 정식으로 흡수하여 한 지붕 아래에서 함께 개발을 해 나가고 있습니다. 2015년에는 회사명을 ElasticSearch 에서 Elastic으로 변경하고, ELK Stack 대신 제품명을 Elastic Stack이라고 정식으로 명명하면서 모니터링, 클라우드 서비스, 머신러닝 등의 기능을 계속해서 개발, 확장해 나가고 있습니다.
Elastic Stack 에는 여러 다양한 솔루션들이 있지만 저는 개인 프로젝트 진행을 위해 ElasticSearch와 원활한 실습을 위해 UI를 제공해 주는 Kibana만 다루도록 하겠습니다.
1.1 ElasticSearch 소개
ElasticSearch는 뛰어난 검색 능력과 대규모 분산 시스템을 구축할 수 있는 다양한 기능들을 제공하지만, 설치 과정과 사용 방법은 비교적 쉽고 간편합니다. 기업에서 뿐만 아니라 학교, 개인을 위한 프로젝트에도 다양하게 사용이 가능합니다. 기존 관계 데이터베이스 시스템에서는 다루기 어려운 전문검색(Full Text Search) 기능과 점수 기반의 다양한 정확도 알고리즘, 실시간 분석 등의 구현이 가능합니다. 또한 다양한 플러그인들을 사용해 손쉽게 기능의 확장이 가능하며 아마존 웹 서비스(AWS), 마이크로소프트 애저(MS Azure) 같은 클라우드 서비스 그리고 하둡(Haddop) 플랫폼들과의 연동도 가능합니다. 다음은 ElasticSearch가 가지고 있는 특징들입니다.
오픈 소스(Open Source)
ElasticSearch의 핵심 기능들은 Apache 2.0 라이센스로 배포되고 있고 Elastic Stack의 모든 제품들은 https://github.com/elastic Github 저장소에서 소스들을 찾을 수 있습니다. 6.3 버전 부터는 Elastic 라이센스와 Apache 라이센스가 섞여 있지만 각각의 버전에 대해 별도 배포판이 존재하고 license 파일에서 어떤 경로의 파일들이 어떤 라이센스로 되어 있는지 확인이 가능합니다.
루씬이 자바로 만들어졌기 때문에 ElasticSearch도 마찬가지로 자바로 코딩이 되어 있습니다. 루씬은 하둡을 개발한 더그 커팅(Doug cutting)에 의해 처음 만들어졌지만 ElasticSearch 엔지니어들 중에는 루씬 커미터들이 다수 있어서 루씬을 매우 깊은 레벨에서 다루고 있고, Elastic 사의 루씬 커미터인 개발자들이 실제로 루씬 프로젝트의 절반 이상의 기능을 개발에 기여하고 있습니다.
실시간 분석(real-time)
ElasticSearch의 가장 큰 특징 중 하나는 실시간(real-time) 분석 시스템입니다. 현재 대용량 데이터 분석에 가장 널리 사용되고 있는 것은 하둡(Hadoop) 플랫폼 위에서 실행되는 Pig, Hive와 같은 다양한 맵 리듀서(Map Reducer)들입니다. 하둡은 기본적으로 배치 기반의 분석 시스템으로 분석에 사용될 소스 데이터, 분석을 수행할 프로그램을 올려 놓고 분석을 실행하여 결과 셋이 나오도록 하는 하나의 루틴으로 실행됩니다.
ElasticSearch는 하둡 시슽쳄과 달리 ElasticSearch 클러스터가 실행되고 있는 동안에는 계속해서 데이터가 입력되고, 그와 동시에 실시간에 가까운(near real-time) 속도로 색인된 데이터의 검색, 집계가 가능합니다.
전문(full text) 검색 엔진
루씬은 기본적으로 역파일 색인(inverted file index)라는 구조로 데이터를 저장합니다. 루씬을 사용하고 있는 ElasticSearch도 마찬가지로 색인된 모든 데이터를 역파일 색인 구조로 저장하여 가공된 텍스트를 검색합니다. 이런 특성을 전문(full text) 검색이라고 합니다.
JSON 문서 기반 ElasticSearch는 내부적으로는 역파일 색인 구조로 데이터를 저장하고 있으나, 사용자의 관점에서는 JSON 형식으로 데이터를 전달합니다. JSON 형식은 간결하고 개발자들이 다루기 편한 구조로 되어 있어 색인할 대상 문서를 가공하거나 다른 클라이언트 프로그램과 연동하기에 용이합니다.
또한 key-value 형식이 아닌 문서 기반으로 되어 있기에 복합적인인 정보를 포함하는 형식의 문서를 있는 그대로 저장이 가능하며 사용자가 직관적으로 이해하고 사용할 수 있습니다. ElasticSearch에서 질의에 사용되는 쿼리문이나 쿼리에 대한 결과도 모두 JSON 형식으로 전달되고 리턴됩니다.
다만 JSON이 ElasticSearch가 지원하는 유일한 형식이기에 사전에 입력할 데이터를 JSON 형식으로 가공하는 것이 필요합니다. CSV, Apache log, syslog 등과 같이 널리 사용되는 형식들은 Logstash에서 변환을 지원하고 있습니다.
RESTFul API
현재 대규모 시슽쳄들은 대부분 마이크로 서비스 아키텍처(MSA)를 기본으로 설계됩니다. 이러한 구조에 빠질 수 없는 것이 REST API와 같은 표준 인터페이스 입니다. ElasticSearch는 REST API를 기본으로 지원하며 모든 데이터 조회, 입력, 삭제를 http 프로토콜을 통해 REST API로 처리합니다.
멀티테넌시(multitenancy)
ElasticSearch의 데이터들은 인덱스(Index)라는 논리적인 집합단위로 구성되며 서로 다른 저장소에 분산되어 저장됩니다. 서로 다른 인덱스들을 별도의 커넥션 없이 하나의 질의로 묶어서 검색하고, 검색 결과들을 하나의 출력으로 도출할 수 있는데, ElasticSearch의 이러한 특징을 멀티테넌시라고 합니다.
1.2 Kibana
Kibana는 ElasticSearch를 가장 쉽게 시각화 할 수 있는 도구입니다. 검색, 그리고 aggregation의 집계 기능을 이용해 ElasticSearch로 부터 문서, 집계 결과 등을 불러와 웹 도구로 시각화를 합니다. Discover, Visualize, Dashboard 3개의 기본 메뉴와 다양한 App 들로 구성되어 있고, 플러그인을 통해 App의 설치가 가능합니다.
Discover
Discover는 ElasticSearch에 색인된 소스 데이터들의 검색을 위한 메뉴입니다. 검색 창에 질의문을 통해 데이터를 간편하게 검색, 필터링 할 수 있으며, 검색된 데이터의 원본 문서를 확인하거나 보고 싶은 필드만 선택해서 테이블 형태로 조회가 가능합니다. 시계열(time series) 기반의 로그 데이터인 경우 시간 히스토그램 그래프를 통해 시간대별 로그 수도 표시됩니다.
Visualzie
Visualize는 aggregation 집계 기능을 통해 조회된 데이터의 통계를 다양한 차트로 표현할 수 있는 패널을 만드는 메뉴입니다. 영역차트, 바차트, 파이차트, 라인차트 등 다양한 시각화 도구들의 사용이 가능하며 여기서 만들어진 패널들을 조합해서 대시보드를 만들게 됩니다.
Dashboard
Visualize 메뉴에서 만들어진 시각화 도구들을 조합해서 대시보드 화면을 만들고 저장, 불러오기 등을 할 수 있는 메뉴입니다. 다른 메뉴들과 마찬가지로 검색 창에 쿼리를 입력하거나 시각화 도구들을 클릭해서 조회할 데이터들의 필터링이 가능하고, URL로 대시보드를 다른 사람들과 공유하거나 JSON 형식으로 내보내고 불러오기 등이 가능합니다.
2. ElasticSearch 설치 및 실행
이번엔 ElasticSearch의 기초적인 사용방법을 익히기 위한 것으로 ElasticSearch를 직접 설치하지 않고 PC에서 zip 파일을 다운받아 bat 파일로 실행시켜 간단히 테스트 해보는 방법으로 진행할 예정이며, 이 때 ElasticSearch 설치와 실행 방법에 대해서만 알아보도록 하겠습니다.
2.1 설치(zip 파일 다운로드)
설치는 굉장히 쉽습니다. 저는 간단한 예제 실행만을 위해서 Windows에서 배치파일(bat)로 실행시키는 zip 버전을 다운받아 사용하였습니다. 저는 ElasticSearch와 Kibana 모두 9.4.2 버전을 사용하였습니다. 9.4.2 버전을 사용한 이유는 딱히 없으며 다운로드 받을 당시 최신 버전이어서 9.4.2 버전을 다운받았습니다. 우선 ElasticSearch는 https://www.elastic.co/downloads/past-releases/elasticsearch-9-4-2 에서 Windows용 zip 파일을 다운받아 줍니다.
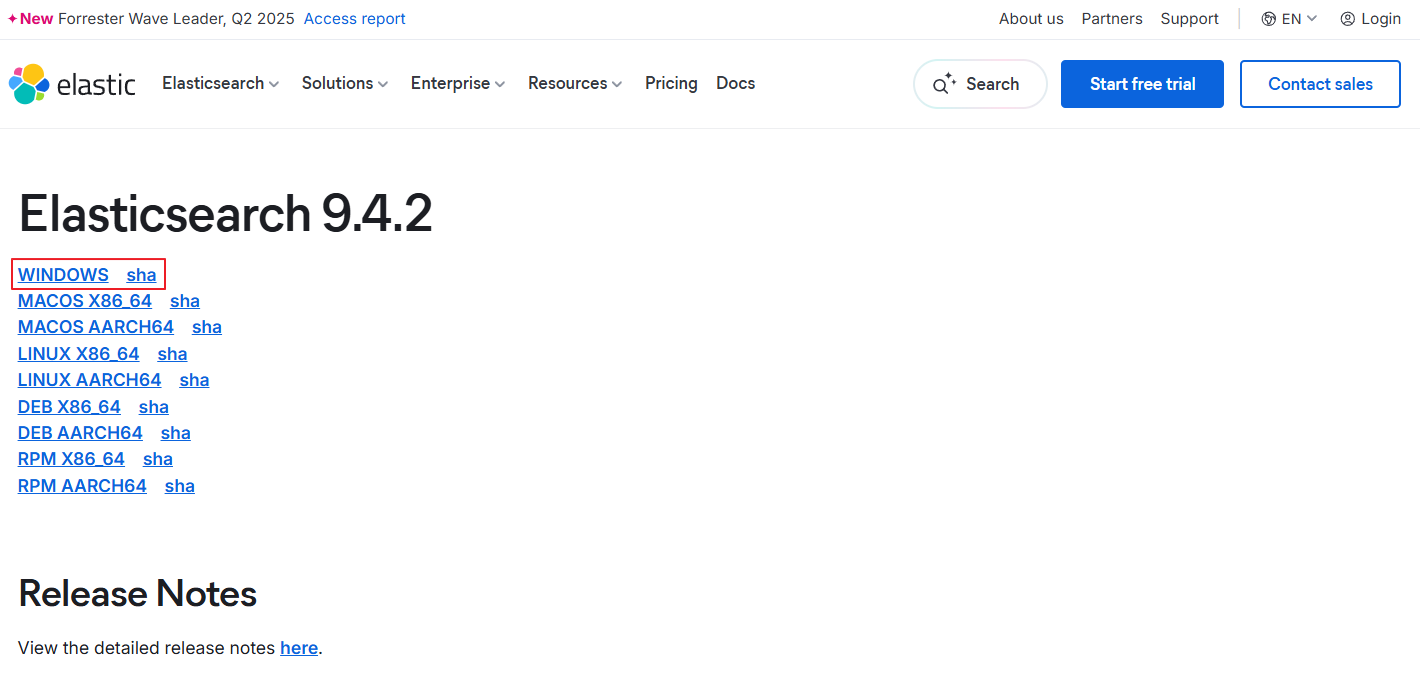
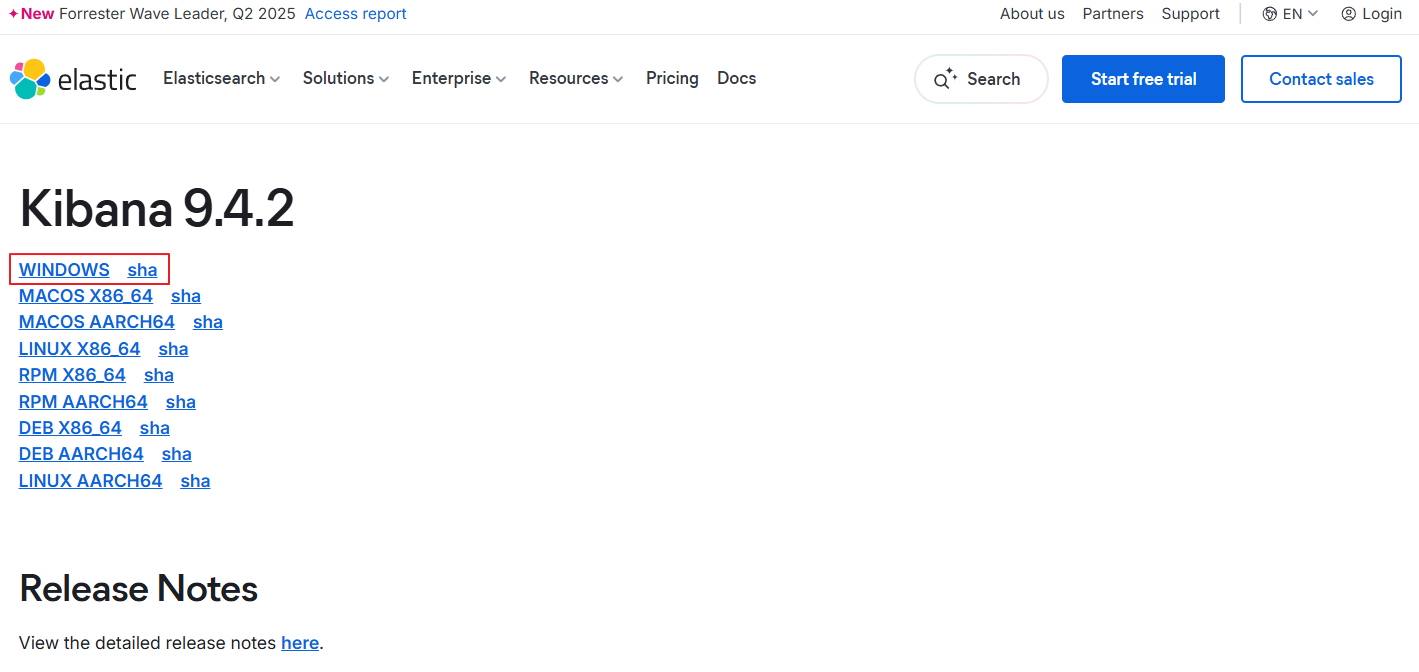
그리고 https://www.elastic.co/downloads/past-releases/kibana-9-4-2에서 Kibana 도 다운받아 줍니다. 저는 조금 더 편리하게 실행시키도록 하기 위해 zip 파일 압축을 푼 다음 나오는 ElasticSearch와 Kibana 디렉토리를 하나의 디렉토리에 같이 넣어 주었습니다.
2.2 실행
실행도 설치만큼 쉽습니다. 다운로드 받아 압축을 해제한 ElasticSearch와 Kibana 디렉토리에서 bin디렉토리로 이동해 줍니다. 그 다음 ElasticSearch는 elasticsearch.bat파일을 Kibana는 kibana.bat 파일을 실행시켜 줍니다.
주의사항으로는 제 경험상 ElasticSearch를 먼저 실행 시킨 후 ElasticSearch가 제대로 실행 된 것을 확인한 후에 Kibana를 실행시켜 줍니다. ElasticSearch가 잘 실행된 것을 확인하기 위해선 http://localhost:9200/에 접속해서 아래 이미지와 같이 나오는지 확인합니다.
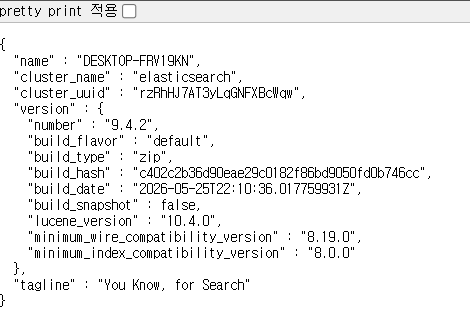
ElasticSearch 실행 후 위와 같은 이미지가 떴다면 Kibana를 실행시켜 줍니다. Kibana는 http://localhost:5601에 접속하여 정상적으로 실행됐는지 확인할 수 있습니다. 아래 이미지와 같이 떳다면 Kibana도 정상적으로 실행된 것입니다.
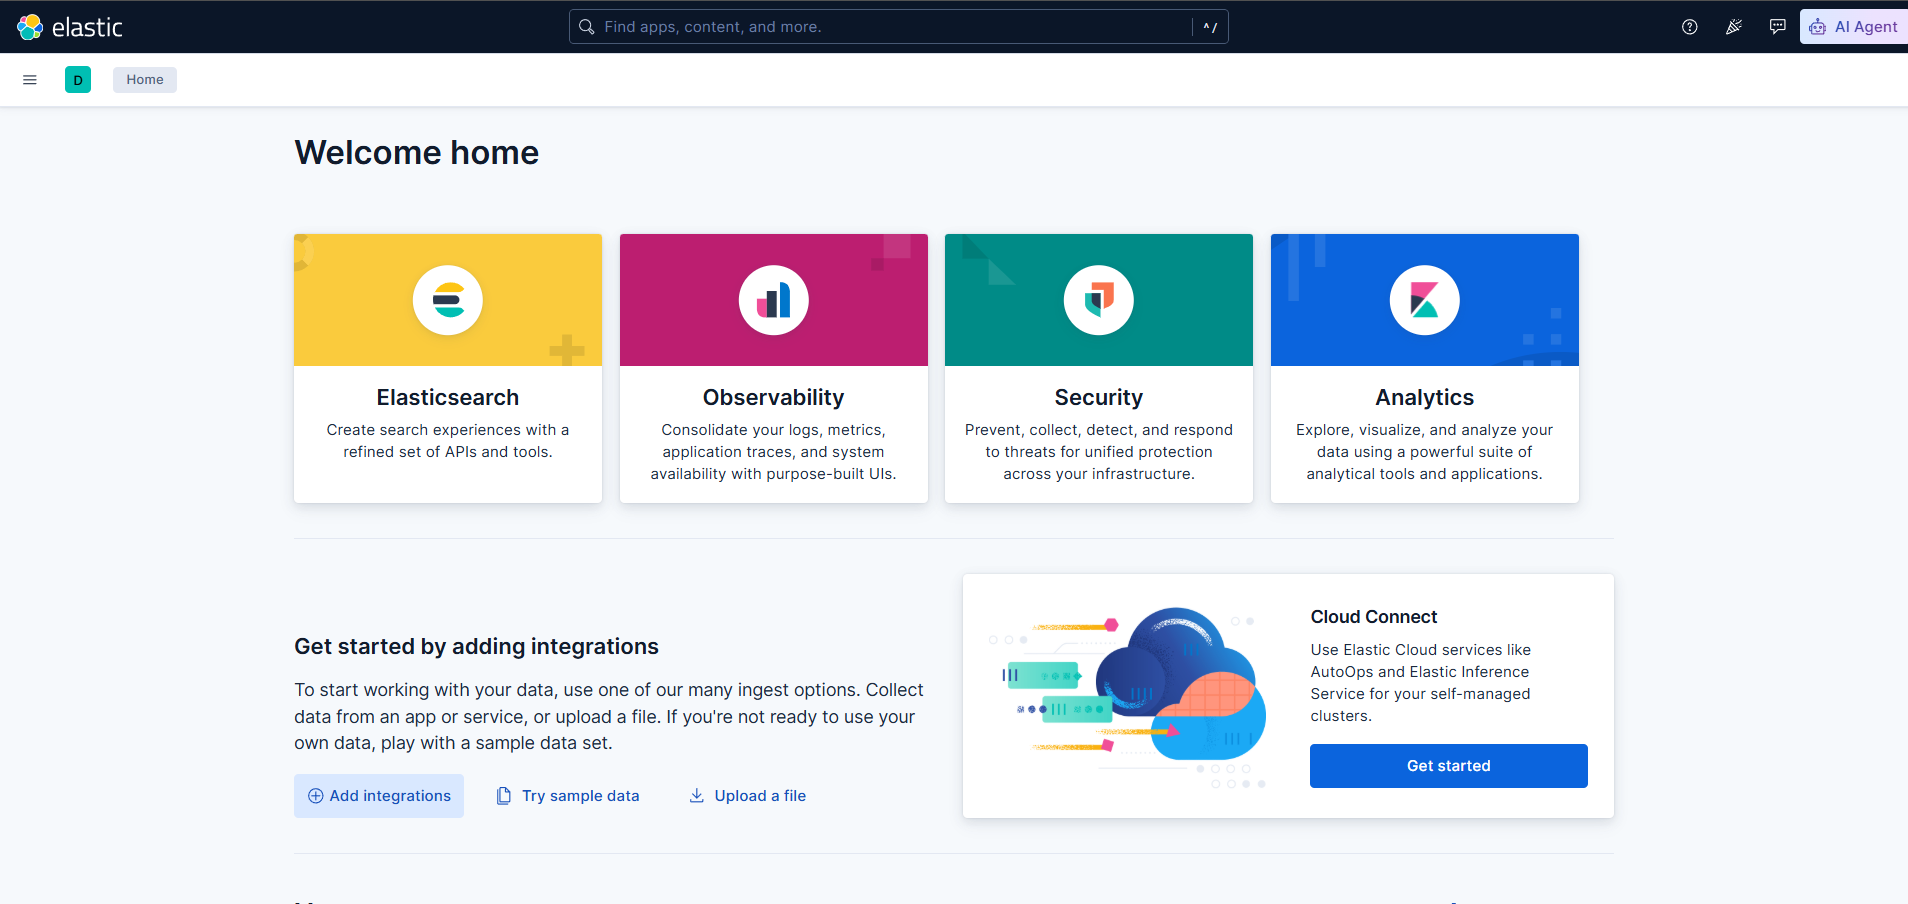
2.3 Kibana를 이용한 ElasticSearch API 사용하기
아래 이미지와 같이 http://localhost:5601에 접속한 뒤 가운데 검색 창에서 “dev”를 입력해 나오는 “Dev Tools”를 클릭합니다
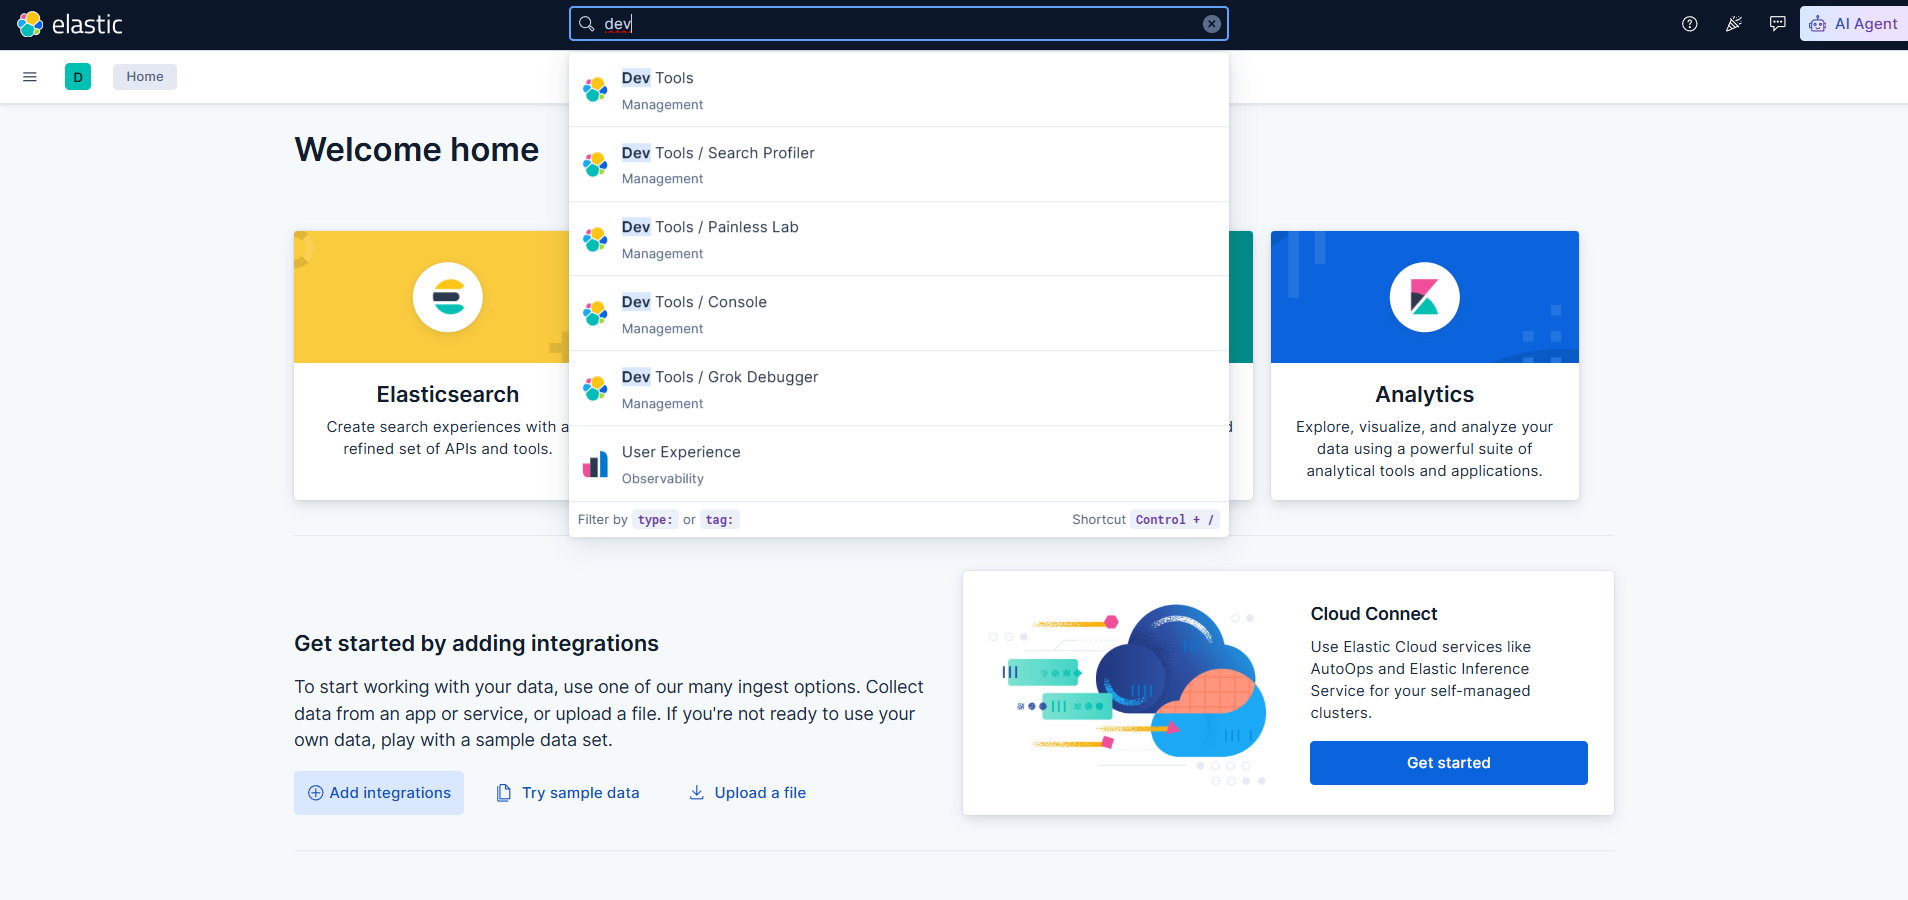
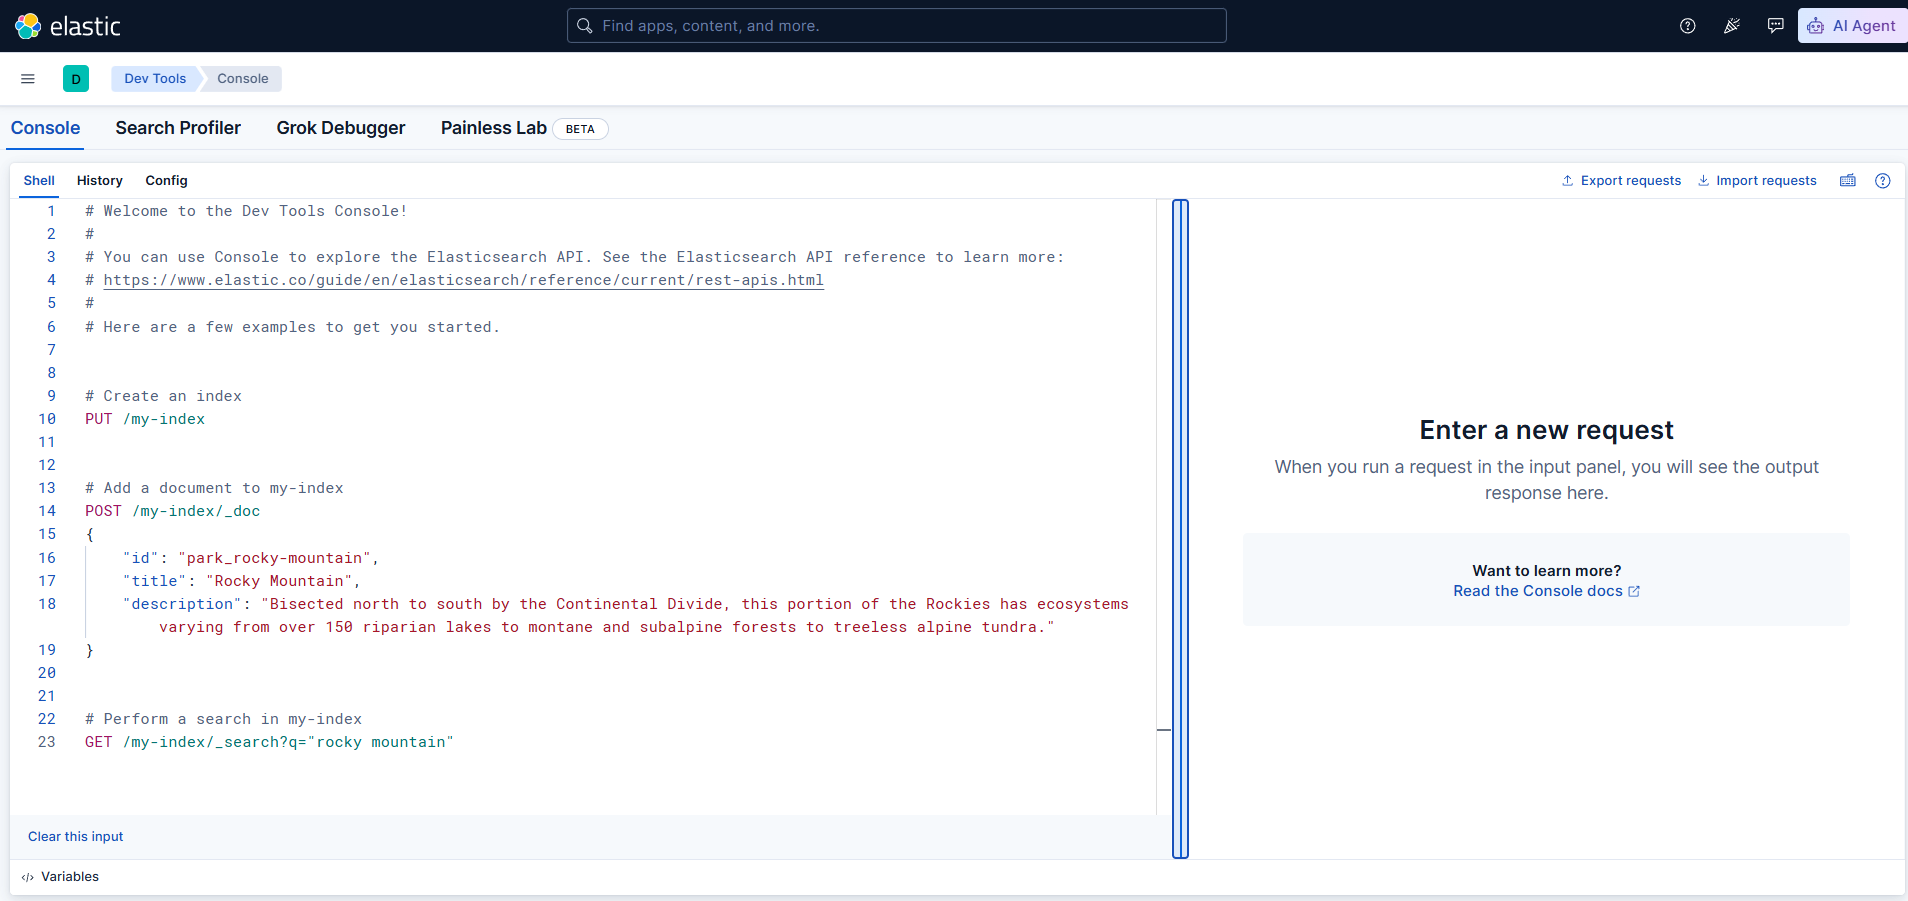
그러면 아래 이미지와 같은 창이 뜨고, 왼쪽에 명령어를 입력하고 실행하면 오른쪽 창에 결과가 표시됩니다.
2.4 ElasticSearch 환경설정
ElasticSearch에는 다양한 환결설정이 있지만 이번에 알아볼 환결설정은 실행에 무리 없이 하도록 하기 위한 jvm.options에 대해서만 알아보도록 하겠습니다.
2.4.1 jvm.options
ElasticSearch는 Java의 가상머신 위에서 실행이 되는데 7.0 기준으로 1gb의 힙 메모리가 기본으로 설정되어 있습니다. 이 설정들은 jvm.options 파일에서 아래 내용들을 수정하여 변경할 수 있습니다. jvm.options 를 설정할 수 있는 파일의 위치는 confing/jvm.options 입니다. 만약 ElasticSearch와 Kibana 실행에 메모리가 부족하다면 아래 값들을 변경해 주시면 됩니다.
-Xms1g
-Xmx1g
Comments